『Gemini 4 Argonって、これまでのGeminiと何が違うの!?』
『ChatGPTのAstraや最新のClaudeより強いの?そこんとこ、数字で知りたいんだけどw』
という人に向けて、今回はGoogleの新モデル「Gemini 4 Argon(ジェミニ・フォー・アルゴン)」を深掘りしていきますよ〜(ΦωΦ)フフフ・・
先に注目ポイントを挙げると、長い推論・資料や動画の理解・複数の工程をまたぐ仕事。さらにAPIでは、長く考えて出力するための枠が大きくなっています。
しか〜し、『全部のテストで最強!もう他のAIは不要!』なんて話ではありません。Astraが上回る項目もあれば、Claudeが得意な項目もあるんです。
従来Geminiとの違い/使える機能と非対応機能/4モデル・19項目のベンチマーク/料金と利用先/ブログ・制作での活用法
ベンチマークはGoogleが2026年10月に公開した集計を基準にしています。
Gemini 4 Argonとは?長い仕事を任せたいGoogleの新モデル!

Argonは、複雑なソフトウェア開発や専門的な調査など、いくつもの手順を踏む課題に向けたGoogleの新しい推論モデルです。2026年9月30日に発表され、10月13日には提供拡大が発表されました。
たとえば、コードを1行書くだけでは終わらない修正。資料を読み、方針を立て、手を動かし、結果を確認する。こうした「考えること」と「作業すること」を行き来する仕事がテーマになっています。
Googleの発表には大規模なコード移行やメモリ最適化の事例もあります。ただし、これはGoogle側の開発環境・検証体制を含む成果。自分のパソコンでも同じ成果が自動的に出る、という意味ではないので分けて見ておきましょう〜!
出典:Google:Argon発表 / Google:10月13日の提供開始発表
ArgonはAIの頭脳にあたるモデル。Geminiアプリ、AI Studio、Antigravityなどは利用する場所です。同じモデルでも、検索・ファイル操作・外部サービス接続など、周囲の機能によってできることが変わります。
ちなみに、この記事でいう「ChatGPT Astra」は比較対象のモデル名としてGPT-6 Astraと表記します。ClaudeはOpus 5.5を中心に、上位モデルのFable 5.1も並べます。Sonnet 5.5やHaiku 5.5もあるので、「最新Claude=1種類」と考えないのがポイントですね。
出典:OpenAI:GPT-6 Astra公式仕様 / Anthropic:Opus 5.5公式仕様
これまでのGeminiから、どこが進化したの!?
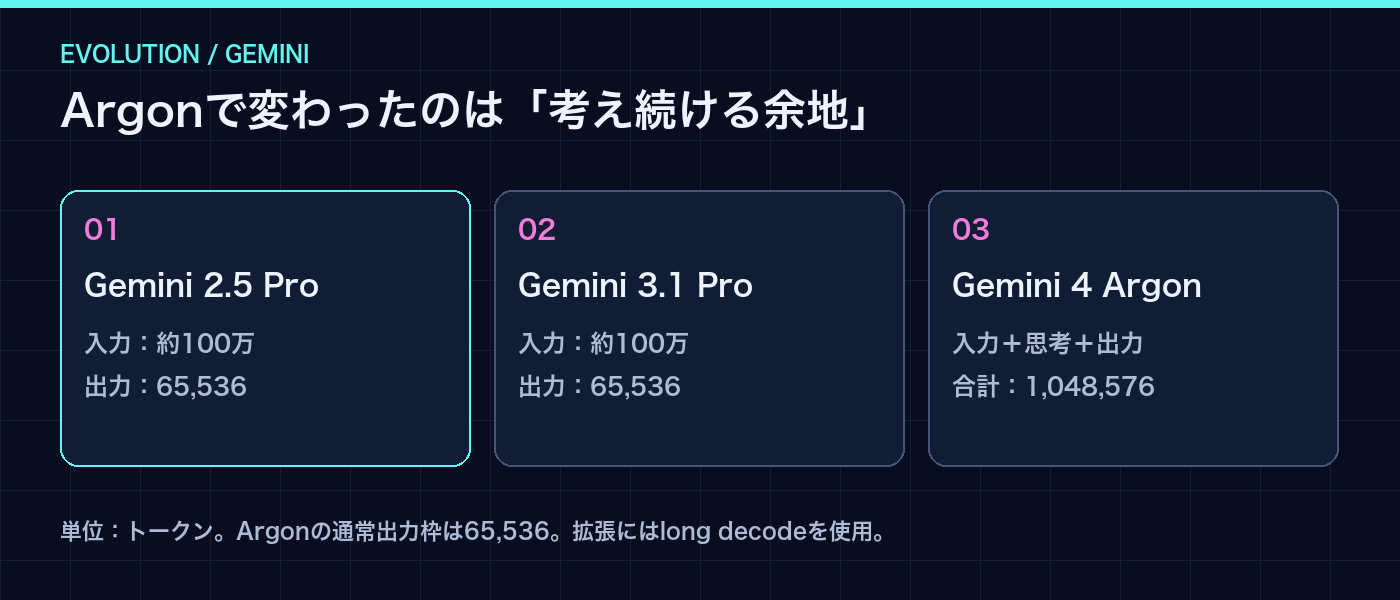
一番誤解しやすいのが、「100万トークンに対応したこと自体が初めて」ではないという点です。Gemini 2.5 Proや3.1 Pro Previewも、すでに約100万トークンの入力枠を持っていました。
| 比較項目 | Gemini 2.5 Pro | Gemini 3.1 Pro Preview | Gemini 4 Argon |
|---|---|---|---|
| 入力・文脈の枠 | 入力1,048,576 | 入力1,048,576 | 入力+思考+出力で1,048,576 |
| 出力の枠 | 65,536 | 65,536 | 通常65,536/long decodeで拡張 |
| 画像・音声・動画・PDFの入力 | 対応 | 対応 | 対応 |
| 検索・コード実行・関数呼び出し | 対応 | 対応 | 対応 |
| 注目する変化 | 長い文脈を扱う推論 | 推論・ツール利用の改善 | 長い推論と出力、複雑な実務への対応 |
出典:Gemini 2.5 Pro公式仕様 / Gemini 3.1 Pro Preview公式仕様 / Gemini API:Argon仕様
トークンはAIが文章などを処理する際の単位で、日本語の「1文字」と同じではありません。Argonでは、読ませた資料、内部の思考、回答が同じ枠を使います。
なので、「100万トークン読ませて、さらに100万トークンの回答を出せる」わけではありません。入力が増えれば、そのぶん思考や回答に使える余地が減る、という仕組みです。
通常の出力枠は65,536トークン。さらに長い処理にはlong decodeを使い、継続処理をつなぎます。Interactions APIではバックグラウンド実行と出力上限の指定が必要です。『上限が大きい=必ず超長文を書く』でもないので、記事の文字数保証として使うものではありませんよ〜。
もうひとつ注目したいのが文章面。Googleは、従来モデルより文体の指示に従いやすく、不要な繰り返しや決まり文句を減らしたと説明しています。ブログ運営者としては、ここも気になりますよねw
ただし、本記事に載せる競合比較表には旧Geminiの同条件スコアがそろっていません。「旧モデルの何倍賢い」といった倍率は出さず、仕様上の変化と公開評価で確認できる強みを分けて紹介します。
Argonで使える機能をまとめてチェック!
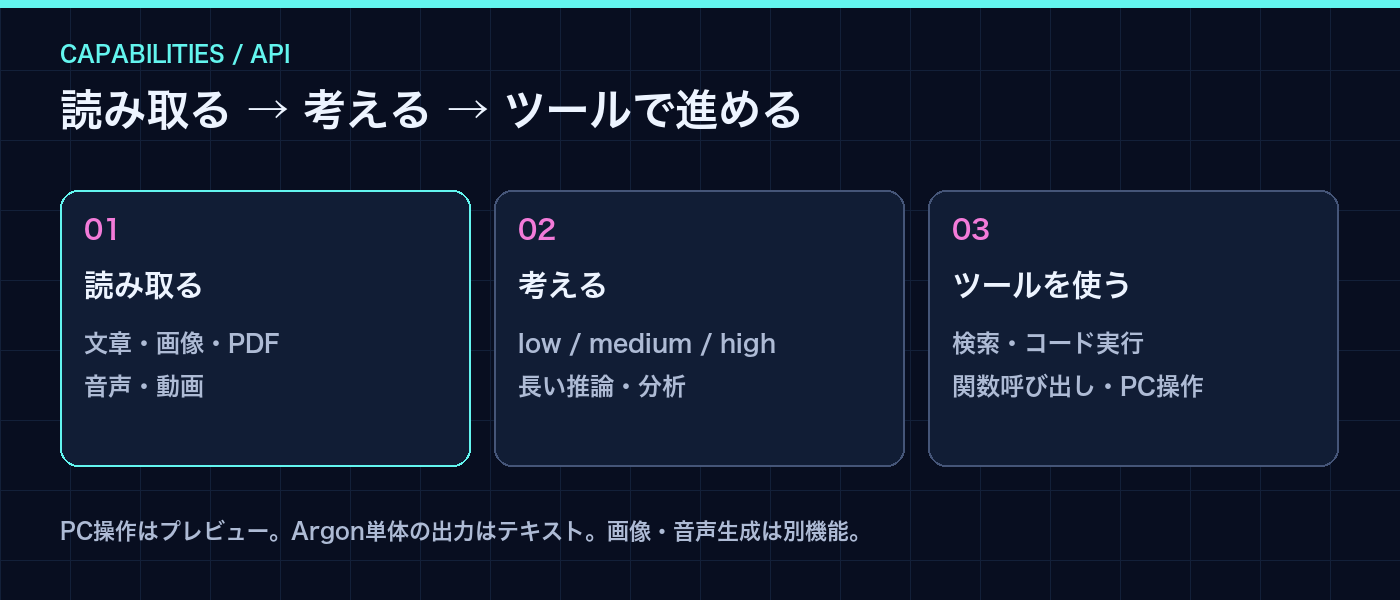
機能一覧は、まずArgonのAPI仕様を基準に整理します。Geminiアプリの各プランで全部そのまま使えるという意味ではありません。
| 機能 | 対応状況 | 何に使う? |
|---|---|---|
| テキスト・画像・PDF・音声・動画の入力 | 対応 | 資料の読み取り、画像や録音内容の分析 |
| テキスト出力 | 対応 | 文章、分析結果、コードの生成 |
| 思考レベルの調整 | low / medium / high | 課題に応じて推論の深さを調整 |
| long decode | 条件付きで対応 | 難しい課題で思考・出力の枠を拡張 |
| 検索グラウンディング・URL context | 対応 | 検索結果やURLの内容を回答の根拠に利用 |
| Google Mapsグラウンディング | 対応 | 場所に関する情報を参照 |
| File search | 対応 | 登録したファイルから関連情報を検索 |
| コード実行 | 対応 | 計算やデータ処理を補助 |
| Function calling | 対応 | アプリ側が用意した外部機能を呼び出す |
| Structured outputs | 対応 | 決めた形式でデータを返す |
| Computer use | プレビュー | 接続環境で画面操作を進める |
| Agentic video understanding | 対応・明示的に有効化 | 必要な場面を探しながら動画を理解 |
| キャッシュ | 暗黙的キャッシュのみ | 共通する入力の再利用時に費用を抑える |
| Batch / Flex / Priority | 対応 | 処理の緊急度・量に合わせた実行方式 |
| 画像生成・音声生成・Live API | Argon単体では非対応 | 別モデルやアプリ側の機能を確認 |
出典:Gemini API:Argon仕様 / Gemini API:推論・最適化
ここで大事なのが、「画像を見られる」と「画像を生成できる」は別ということ。Argonに絵を読み取らせたり、画像生成ツールを使う手順を考えさせたりすることと、Argon自身が画像を出力することは分けて考えましょう。3D作品の制作も、コードやBlenderなど周辺ツールを組み合わせる話です。
動画には通常の固定間隔で読み取る方式と、必要な場面を探すagentic方式があります。初期状態はstatic。長い講義から特定の話題を探すときなどはagentic方式が候補ですが、短い動画や全編の要約では通常方式が向く場合もあります。なお、agentic動画理解は3.8 Flashなどにもあり、Argonだけの専用機能ではありません。
Argonは明示的キャッシュが非対応。temperature・top_p・top_kは指定しても無視されます。思考レベルの初期値はmedium。長い処理では出力枠とタイムアウトも見直しましょう。
Astra・最新Claudeと比較!ベンチマーク19項目を並べてみた
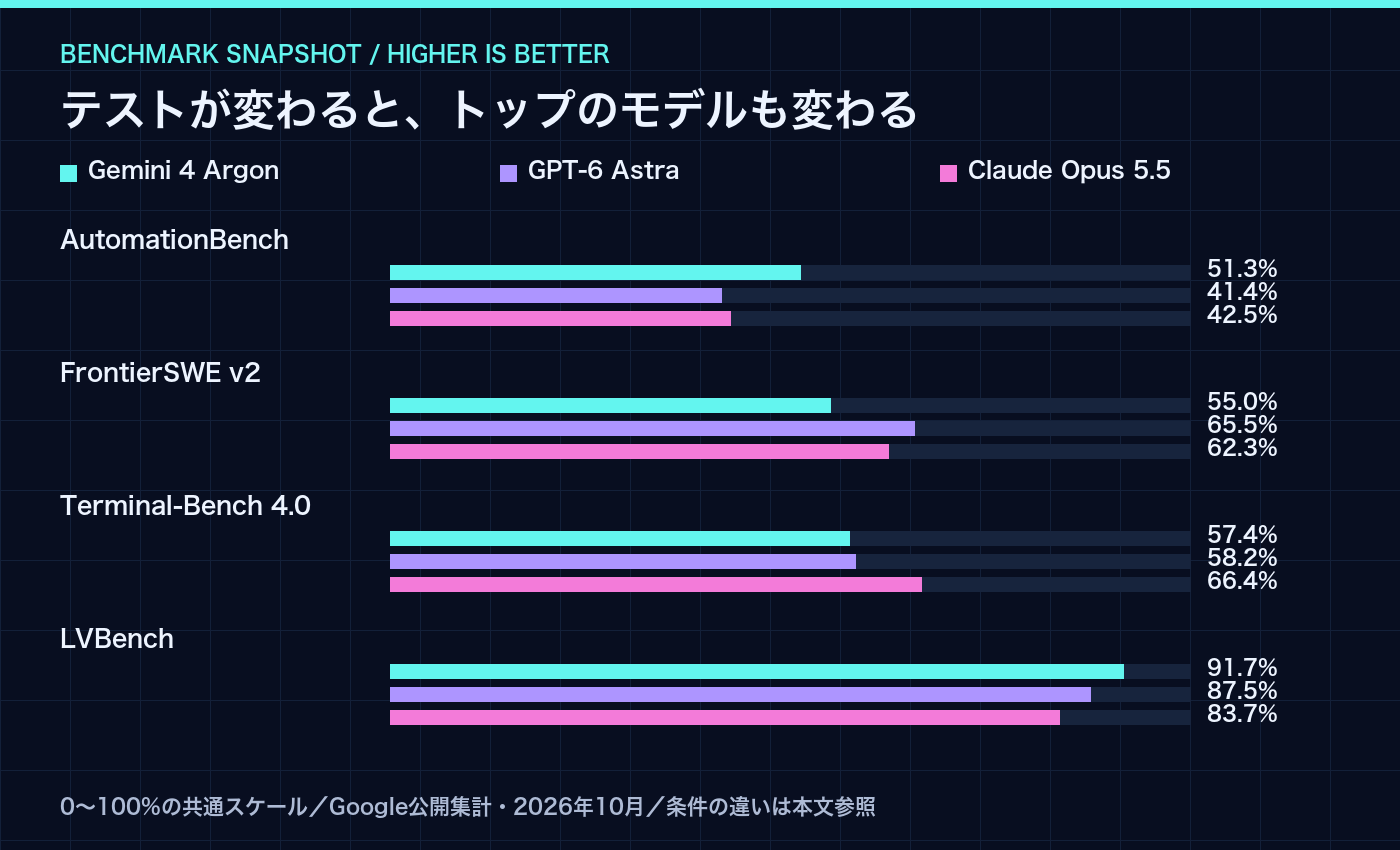
ここからが本題です💪🤩 下の数字は、Google DeepMindがArgonのモデルカードに掲載した比較値。すべて値が高い方が良い指標ですが、テストごとに測っている能力や採点方法が違います。
各行の太字は、この表にあるモデルの中での最大値です。未掲載は「—」で表示し、0点とは扱いません。
| 分野 | ベンチマーク | Argon | GPT-6 Astra | Fable 5.1 | Opus 5.5 |
|---|---|---|---|---|---|
| 業務 | Vals Index | 68.9% | 63.1% | 65.8% | 67.0% |
| 業務 | AutomationBench | 51.3% | 41.4% | 31.4% | 42.5% |
| 業務 | Vals Finance Agent v2 | 65.4% | 53.5% | 58.9% | 58.6% |
| 業務 | Harvey Legal Agent | 19.6% | 5.4% | 6.7% | 3.8% |
| 開発 | DeepSWE v1.1 | 77.9% | 74.1% | 67.4% | 74.2% |
| 開発 | FrontierSWE v2 | 55.0% | 65.5% | 56.3% | 62.3% |
| 開発 | Vibe Code Bench | 91.9% | 89.6% | 90.3% | 90.3% |
| 開発 | Terminal-Bench 4.0 | 57.4% | 58.2% | 57.9% | 66.4% |
| ML開発 | PostTrainBench | 45.3% | 44.3% | 40.2% | 49.3% |
| 科学 | Terminal-Bench Science 0.1 | 57.6% | 68.1% | 52.6% | 63.3% |
| 科学 | LABBench 2 | 88.8% | 85.4% | 68.6% | 73.1% |
| 数学 | RiemannBench | 76.0% | 72.0% | 65.6% | 69.6% |
| 長文 | GraphWalks ≤128K / BFS F1 | 99.7% | 98.7% | 91.4% | 90.6% |
| 長文 | GraphWalks 256K–1M / BFS F1 | 84.2% | 71.8% | 65.0% | 66.8% |
| PC操作 | Agent’s Last Exam | 39.5% | 34.2% | — | 38.2% |
| PC操作 | OSWorld 2.0 / offline・部分点 | 69.2% | 72.6% | — | — |
| 図表 | Chartography | 71.6% | 71.0% | 46.2% | 66.3% |
| 動画 | LVBench | 91.7% | 87.5% | 79.7% | 83.7% |
| 防御 | CWE-bench v1 | 68.0% | 68.0% | 58.0% | 67.0% |
出典:Google DeepMind:Argonモデルカード / Google DeepMind:評価方法
Harvey Legal AgentはHarvey’s Legal Agent Benchmarkの略記。GraphWalksは幅優先探索(BFS)のF1値です。OSWorld 2.0はoffline subsetの部分点。PostTrainBenchの評価方法はv1.1を使用しています。異なる指標の平均点は算出していません。
① 業務系ではArgonが目立つ!
Vals Indexは金融・開発・法務・税務などをまとめた指標。AutomationBenchは業務の一連の操作を評価します。掲載値ではArgonが上回っていて、資料を読んで業務を進める用途で試す理由になります。ただし、米国経済の重み付けを使うVals Indexを、日本語ブログの文章力ランキングとして読むのは無理があります。
② 開発は、テストによって結果が入れ替わる!
DeepSWEではArgonがトップですが、FrontierSWEではAstra、Terminal-BenchではOpus 5.5が上です。『プログラミングならこのモデル一択!』と決めつけるより、自分のコードと作業手順で確認するのがよさそうですね。
③ 長文・動画はArgonの見どころ!
GraphWalksの長い入力帯やLVBenchではArgonが高い数値。ただし、長文推論のテストが良いことと、どんな巨大資料でも抜け漏れなく読めることは別。動画の入力条件にも差があるので、次の説明もセットで見てください。
④ 科学・PC操作も万能ではない!
Argonが上回る科学系評価がある一方、Terminal-Bench ScienceやOSWorldの掲載条件ではAstraが上回ります。得意・不得意が混ざるのが実際の比較なんです。
出典:Google:Argon発表 / Google DeepMind:Argonモデルカード / Google DeepMind:評価方法
ベンチマークで失敗しないための読み方!
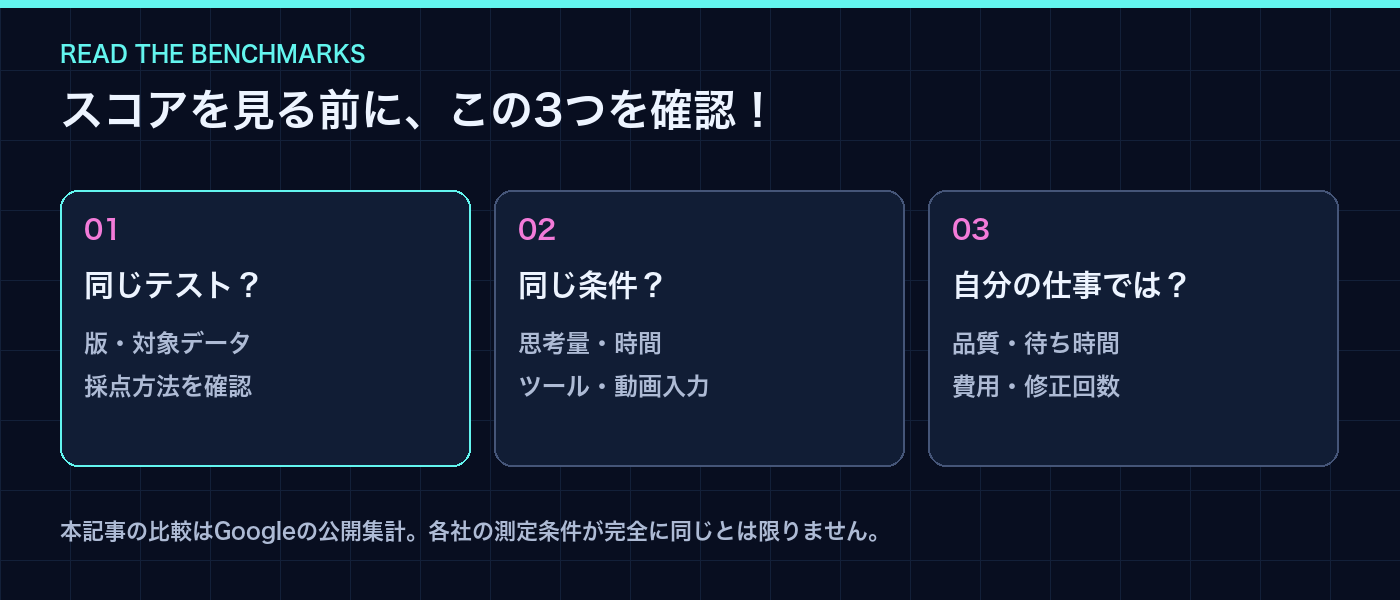
『数字が並んでるんだから、いちばん高いのを選べばOKでしょ?』と思うかもしれませんが、ここはちょっと立ち止まりたいところですw
- 同一環境で4モデルを測り直した表ではない。Googleの自社評価、各社の公表値、第三者の公開ランキングが混在しています。
- 基本は高い思考設定。普段使う標準設定と同じ品質・速度・費用になるとは限りません。
- ツールや実行環境も成績に影響。エージェントを動かす仕組み、制限時間、利用できる操作が違えば結果も変わります。
- 動画の入力条件が違う。LVBenchはGeminiが1FPS、Astraが800フレーム、Fableが300、Opusが600フレーム。API制約による差があります。
- OSWorldの「—」には理由がある。Anthropicはonlineとofflineを合わせた結果を公表しているため、offlineだけのこの表には採用されていません。
たとえば小さな点差だけで「体感でも必ず上」とは言えません。Anthropic自身も、Opus 5.5とFable 5.1の実利用の差はスコアほど大きくないと説明しています。
ベンチマークで候補を絞り、同じ仕事を渡して「品質・時間・費用」を比べる。この順番なら、自分に合うAIを選びやすくなりますよ〜!
どこで使える?料金と100万トークンの注意点!
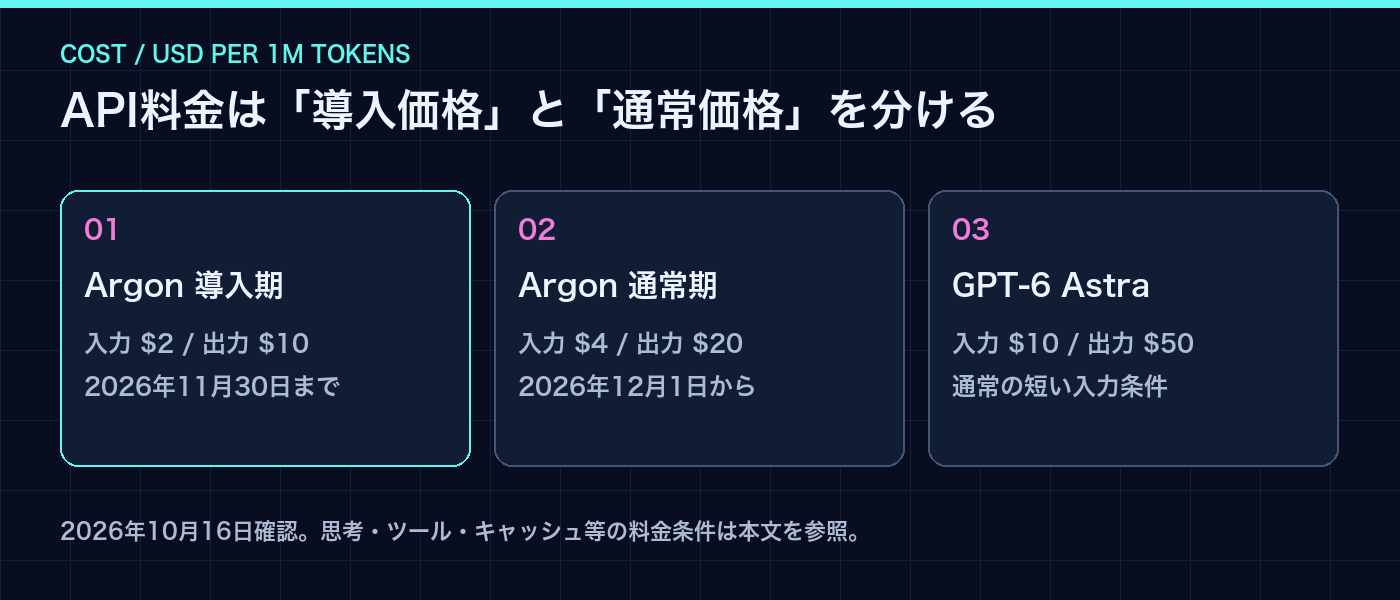
APIで使う場合は、Gemini APIやGoogle AI Studioが入口です。Googleの10月13日の発表では、GeminiアプリやAntigravityなどへの展開も案内されています。
10月13日の提供開始ブログにはGeminiアプリ・AI ModeでPro対応という記載がある一方、APIの料金・移行ページには「Google AI Proでは利用不可」という記載が残っています。2026年10月16日時点では一律に断定せず、契約前に自分の地域・プラン・モデル選択画面でArgonが使えるか確認してください。
出典:Google:10月13日の提供開始発表 / Gemini API:料金 / Gemini API:Argon新機能・移行ガイド
| モデル/期間 | 入力:100万トークン | 出力:100万トークン |
|---|---|---|
| Argon:2026年11月30日まで | $2 | $10 |
| Argon:2026年12月1日以降 | $4 | $20 |
| GPT-6 Astra:通常料金 | $10 | $50 |
| Claude Opus 5.5:通常料金 | $4 | $20 |
| Claude Fable 5.1:通常料金 | $10 | $50 |
出典:Gemini API:料金 / OpenAI:GPT-6 Astra公式仕様 / Anthropic:API料金
米ドル建てのAPI基本単価。月額プラン、税、為替、ツール料金、キャッシュ、Batch、優先処理等は別条件です。Astraは入力が272Kを超えるとリクエスト全体の入力・キャッシュ単価が2倍、出力単価が1.5倍になります。
導入期間のArgonは、表のAstra基本単価と比べると入力・出力ともに5分の1。ただし、1回の仕事で何トークン使うかまで同じではないので、「仕事の総額も必ず5分の1」とは言えません。
たとえば導入価格で、入力10万・課金対象の出力1万トークンだけなら、単純計算は$0.30です。通常期の同条件では$0.60。これは追加のツールや継続処理を含めない計算例ですよ〜。
Argonでは思考トークンも出力料金に含まれます。またlong decodeは継続するたびに、それまでの内容を入力に戻すため、課金される入力の合計は最初の指示文だけではありません。使い終わったら利用量の表示もチェックしましょう。
出典:Gemini API:料金 / Gemini API:long decode
| 仕様 | Argon | GPT-6 Astra | Claude Opus 5.5 |
|---|---|---|---|
| 文脈の枠 | 1,048,576・共有 | 1,050,000 | 1M |
| 通常の最大出力 | 65,536 | 128,000 | 128K |
| 長い出力の特記事項 | long decode:共有枠の残りまで | 公式仕様の最大出力を参照 | Batch APIベータで300K |
出典:Gemini API:Argon仕様 / OpenAI:GPT-6 Astra公式仕様 / Anthropic:Opus 5.5公式仕様
同じ「約100万」という数字でも、入力・思考・出力の数え方や拡張条件が違います。読み込める量と、最終回答として書ける量をセットで見るのがコツです。
ブロガーやクリエイターなら、こう使ってみたい!
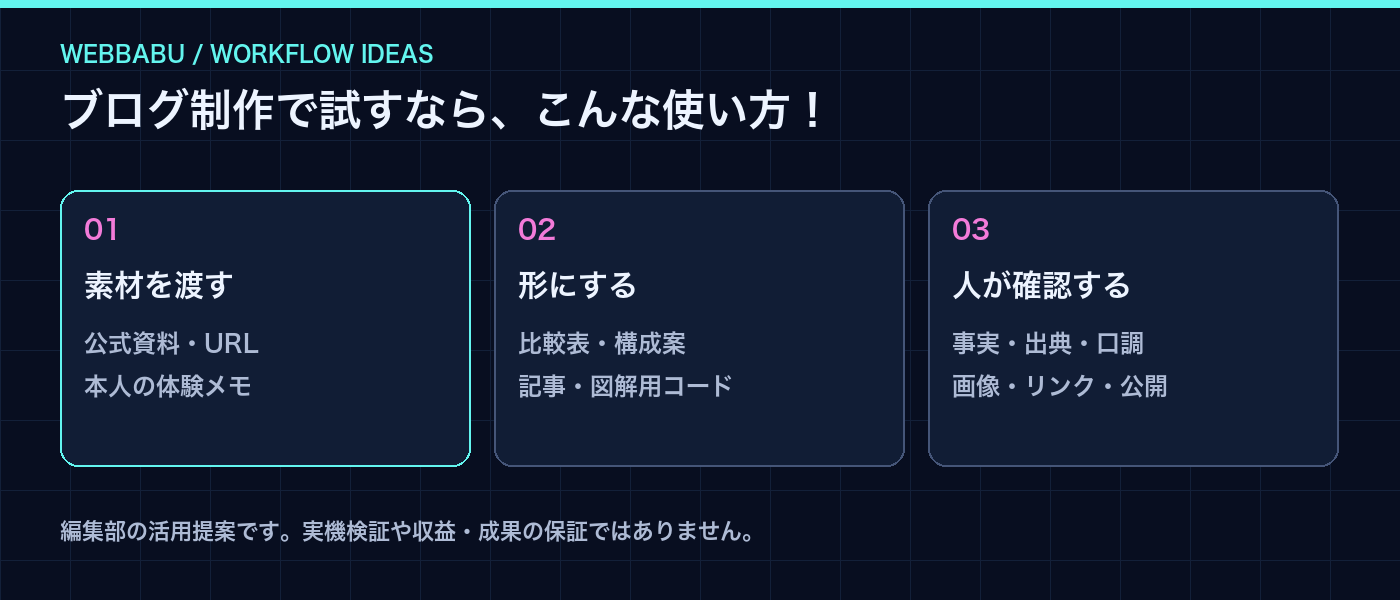
さて、スペックがすごいのは分かったけど、自分には何が関係あるの!?という人向けに、僕なら試したい使い方を整理しますね。
① 公式資料から、出典付きの比較記事を作る
複数のサービスの資料を渡して、機能・料金・対象ユーザーを同じ項目で整理。そこから記事の構成を組みます。表の空欄を勝手に補完させないよう、「確認できない項目は未確認」と指定するのがコツです✅
② 長い動画から、記事に使う場面を探す
発表会や講義から、特定機能を説明しているタイムスタンプと要点を整理。動画の内容を全部文章にするより、知りたい部分を指定した方がチェックもしやすくなります。
③ ブログ用の計算ツールや図解を作る
料金シミュレーター、比較表、ブラウザーで動く図解などのコード作成を相談。画像そのものが必要なら画像生成機能を組み合わせます。公開前にスマホ表示や入力値の扱いを確かめるところまでが制作ですね。
④ 自分の文体に合わせて原稿を整える
過去記事と、自分が本当に体験したことのメモを渡して調整します。『使って最高でした!』みたいな存在しない体験談を足されたら困っちゃいますからねw
添付した公式資料だけを根拠に、初心者向けの比較記事を作ってください。機能、料金、利用条件を表にし、各項目に出典URLと確認日を付けてください。資料間に矛盾があれば隠さず示してください。文体は添付した私の過去記事を参考にし、体験していないことは体験談として書かないでください。最後に、人間が公開前に確認する項目を列挙してください。
この4つは機能から考えた活用案で、Argonでの実測レビューではありません。同じ依頼をAstraやClaudeにも渡して、手直しの少なさまで比べると自分との相性が見えてきますよ〜。
結局どれを選ぶ?Argonは試す価値のある強力な候補!
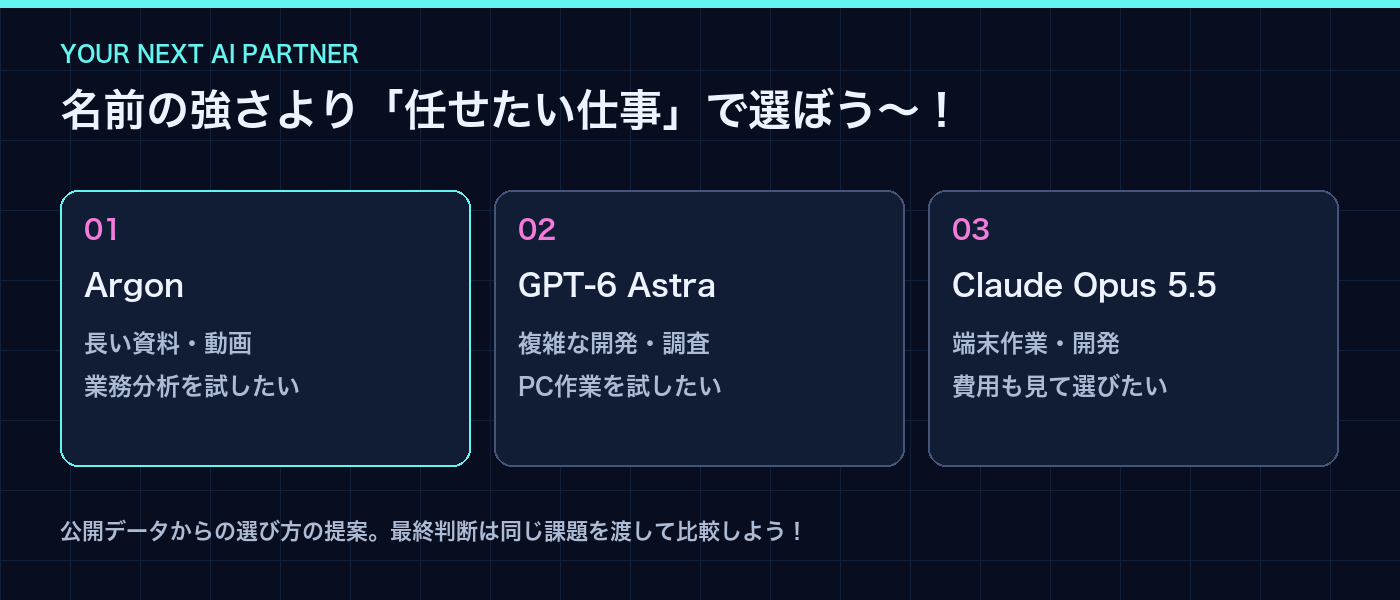
今回の公開データから見ると、Argonは長い資料や動画、業務分析を含む仕事で試したいモデルです。Astraは複雑な開発・科学系の作業やPC操作、Opus 5.5は端末作業を含む開発と費用のバランスで比較候補になります。
もちろん、これは表から考えた選び方。文章の好み、日本語の自然さ、使い慣れたアプリとの連携まで、ベンチマークだけでは決まりません。
今回の進化で注目したいのは、「長い内容を入れられる」だけでなく、「長く考えて仕事を進めるための余地」が広がったこと。そのうえで、検索や動画理解、コード実行などをどう組み合わせるかが使いこなしのポイントになりそうです。
まずは、自分が普段ちょっと面倒だと感じている作業を1つ選んでみましょう。比較記事の下調べでも、動画の整理でもOK。同じ課題を渡してみれば、スペック表だけでは分からない違いが見えてくるはずですよ〜(ΦωΦ)フフフ・・
公開仕様・料金・利用条件は変更される場合があります。情報確認日:2026年10月16日。図解:ウェブバブ向けに独自制作。アイキャッチ:AI生成によるコンセプト画像で、Google公式画像ではありません。
参照した公式資料一覧
- Google:Argon発表
- Google:10月13日の提供開始発表
- Google DeepMind:Argonモデルカード
- Google DeepMind:評価方法
- Gemini API:Argon仕様
- Gemini API:Argon新機能・移行ガイド
- Gemini API:long decode
- Gemini API:動画理解
- Gemini API:料金
- Gemini API:推論・最適化
- Gemini 2.5 Pro公式仕様
- Gemini 3.1 Pro Preview公式仕様
- OpenAI:GPT-6 Astra公式仕様
- Anthropic:Opus 5.5公式仕様
- Anthropic:API料金
- Anthropic:Opus 5.5発表